开源全双工语音模型排名第一,最快0.31秒开口
开源全双工语音模型排名第一,最快0.31秒开口

Ai热点前沿11-10 06:09
2026-11-10 14:09
导语:单卡80GB,0.31秒首包还能识别笑声叹气。Sophon-Realtime v1是什么 Sophon-Realtime
Sophon-Realtime v1是什么
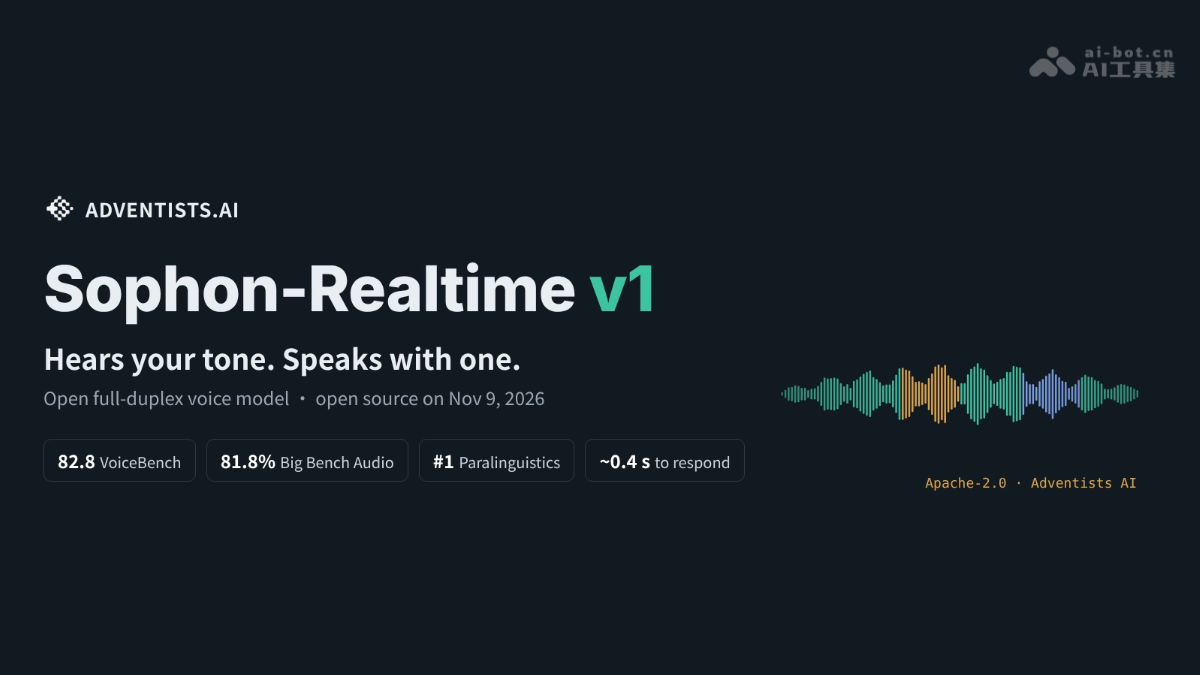
Sophon-Realtime v1 是 AI降临派(Adventists AI)开源的全双工语音模型,能边听边判断话轮,随时被打断,能听懂语气、笑声和叹气,用带感情的声音回应。Sophon-Realtime v1基于 32B 参数,在语音评测 VoiceBench 上达 82.8 分,开源全双工模型中排名第一。Sophon-Realtime v1提供 Tag(表现力强)、Flash(响应快)和 E2E(研究预览)三个版本,单张 80GB 显卡即可部署,采用 Apache-2.0 许可,可商用。
Sophon-Realtime v1的主要功能
- 全双工对话:说话时一直在听,一停就接上,随时插话立刻停下回答新问题。
- 听懂语气:能识别犹豫、重音、笑声、叹气、反话等副语言信息,不只是听字面内容。
- 说得出语气:回答时声音里会自然地笑、叹气、清嗓子、换气,而不是念出文字。
- 多模态理解:给它看图表和截图,能读得懂并口头解读。
- 工具调用:支持多步工具调用(Full-Duplex-Bench v3 Pass@1 达 48%),能”干活”。
- Live 模式:兼容 OpenAI GPT-Live 协议,可与大模型后端联合工作。
- 快速部署:一条命令、一张 80GB 显卡即可上线,Flash 版首包仅 0.31 秒。
- 可微调:基于 ms-swift 用 LoRA 微调人设、口吻、领域知识和工具调用习惯。
Sophon-Realtime v1的技术原理
- 一个模型,边听边判断:音频持续流入模型,每次用户停顿时,同一个 32B 模型只用一个 token 能判断出用户状态,是说完了、还在说、在附和还是在思考。不需要串接独立的语音识别、静音检测、话轮检测和语音合成模块,大大简化了传统语音助手的流水线架构。
- 提前起草,准时开口:用户第一次停顿时,模型就开始起草回复;判断轮到自己的那一刻立刻开口说话。如果用户还在继续说,草稿会在被听到之前自动丢弃,避免抢话。
- 不只写说什么,也写怎么说:大脑生成回复时,会同步标注声音标签(如 [laughter]、[sigh]、[cough]、
<strong>重读词),指示哪里该笑、该叹气、该换气。Tag 和 Flash 版本共享同一个大脑,仅由不同的声音模型来”表演”标记,且标记不会被念出来。 - 文字领先半步,声音同步跟上:文字和声音并行流式生成,文字始终领先半步,兼顾端到端模型的速度优势,同时每句话都有可审计的文字记录,便于接工具调用和更大的后端模型。
- 记得你真正听到了什么:对话历史保存双方的真实音频,用户打断时只保留用户实际听到的部分,确保下一轮对话不会接错话、不会重复已说过的内容。
微信关注回复“开源”,加入AI开源项目交流群
如何使用Sophon-Realtime v1
- 安装环境:确保系统为 Linux + CUDA + Python 3.12,运行
pip install sophon-realtime。 - 启动服务:运行
sophon-realtime serve,首次启动自动下载约 42GB 的 Tag 权重,之后服务监听在 8000 端口。 - 调用接口:通过
ws://HOST:8000/v1/realtime(全双工)或POST /v1/chat/completions(语音进、文字+语音出)与模型交互。 - 测试对话:运行
python client_example.py --wav 我的问题.wav --lang zh --voice vivian_zh发送一段语音并收听回复。 - 接入 Live 模式(可选):在引擎旁运行
cd sophon-realtime/live && BUILD=tag PORT=8000 LIVE_PORT=8780 bash start_live.sh,即可用 OpenAI GPT-Live 协议接入你的后端大模型。 - 微调定制(可选):用 ms-swift 以 LoRA 方式在 80GB 显卡上训练,准备 jsonl 格式对话数据(音频写
<audio>、回复加[laughter]等标签),执行swift sft命令即可改人设和领域知识。
Sophon-Realtime v1的核心优势
- 开源全双工第一:VoiceBench 得分 82.8,与 GPT-4o-mini-Audio 持平,超越 MiniCPM-o 4.5(76.1)等其他开源全双工模型。
- 语音推理最强:在 1,000 道语音推理题 Big Bench Audio 上答对 81.8%,远超此前最好的开源模型 Raon SpeechChat(58%)。
- 听懂语气:听觉模型 DuplexJev 在 LISTEN、StressTest、MSPB 副语言基准综合排名第一(48.6),高于 Gemini 3.8 Flash 和 Qwen3-Omni。
- 说得出语气:NVV-SuperBench 上 Tag 版中文 0.86、英文 0.80,笑声、叹气、清嗓子等表演最像。
- 能干活:Full-Duplex-Bench v3 工具调用 Pass@1 达 48%,高于 Grok(43%),该接话时 100% 接上。
- 快且扛得住人:Flash 版首包 0.31 秒,单卡支持 40 路并发;Tag 版约 0.6 秒、16 路并发。
Sophon-Realtime v1的项目地址
- GitHub仓库:https://github.com/adventists-ai/sophon-realtime
Sophon-Realtime v1的同类竞品对比
| 对比维度 | Sophon-Realtime v1(AI降临派) | MiniCPM-o 4.5(面壁智能) |
|---|---|---|
| 产品定位 | 专注全双工语音对话的”听+说”智能体 | 全模态通用模型,全双工是核心特性之一 |
| 参数规模 | 32B(Tag/Flash/E2E 三版共享大脑) | 9B 端到端(SigLIP2+Whisper+CosyVoice2+Qwen3-8B) |
| VoiceBench | 82.8(开源全双工第一) | 76.1 |
| 全双工架构 | 单 token 判断话轮状态+提前起草回复,被打断即丢弃草稿 | TDM 时分复用同步多模态流+TAIL 时间对齐交错语音生成 |
| 打断处理 | 打断后只保留用户已听到的真实音频,不会接错话 | 支持边说边听、随时插话的自由对话 |
| 语音表达力 | NVV-SuperBench 中文 0.86,会笑、叹气、清嗓子 | 中文 CER 0.86%、英文 WER 2.38%,长文本合成稳定、情感控制领先 |
| 声音克隆 | 提供多种固定音色(如 vivian\_zh、chelsie) | 3 秒参考音频即可克隆音色,相似度 92.7% |
| 视觉能力 | 能读图表、截图 | 接近 Gemini 2.5 Flash,OCR/文档解析达 OmniDocBench 业界最佳 |
| 部署门槛 | 1 张 80GB 显卡(H100/A100),一条命令起服务 | INT4 量化仅需 11–12GB 显存,RTX 5070 级消费卡可跑全双工 |
| 速度与并发 | Flash 首包 0.31s,单卡 40 路并发;Tag 0.6s / 16 路 | INT4 解码 212 tokens/s,全双工实测端到端约 210ms±15ms,以单路交互为主 |
| 端侧生态 | 面向云端 GPU 部署 | llama.cpp-omni 支持笔记本/手机,已适配昇腾、海光等国产芯片 |
| 接口协议 | ws `/v1/realtime`+OpenAI GPT-Live 兼容,可联合后端大模型 | vLLM / SGLang / Ollama / llama.cpp,OpenAI 实时接口风格 |
| 微调定制 | ms-swift LoRA 微调,保留声音标签与接话能力 | MiniCPM 社区微调生态成熟 |
| 商用许可 | Apache-2.0(代码+权重) | Apache-2.0 |
Sophon-Realtime v1的应用场景
- 智能客服:Flash 版首包 0.31 秒、单卡 40 路并发,能听懂客户情绪并多步调用工具办理业务,适合大规模呼叫中心。
- AI 陪伴与虚拟角色:Tag 版语气表现力最强,会笑会叹气,适合做情感陪伴、虚拟恋人和游戏 NPC。
- 车载语音助手:全双工随时插话、低延迟响应,无需唤醒词,听懂语气还能辅助判断驾驶员状态。
- AI 硬件终端:团队技术已落地 300 多款硬件产品,Apache-2.0 许可可商用,适合集成进音箱、玩具、机器人等设备。
- 企业语音智能体:Live 模式兼容 GPT-Live 协议,Sophon 负责”听和说”,把查询办事交给后端大模型,适合银行、政务、航空等行业定制服务。
来源:AI工具集
#AI工具
免责声明:含第三方意见,不构成财务建议
分享至


推荐阅读
Step Code – 阶跃星辰开源的终端编程智能体
09-24
Hy4 preview 轻量版 – 腾讯混元开源的Hy4量化压缩模型
09-02
Claude Fable 5.1 – Anthropic 推出的最新旗舰大模型
09-02
开源版Retool来了,60+组件拖拽搭后台
08-19
Claude Opus 5来了:半价逼近Fable 5
07-25
腾讯开源260个真实任务,考AI打工能力
07-25
美团开源AI考场:813个Minecraft任务
07-25

Step Code – 阶跃星辰开源的终端编程智能体

Hy4 preview 轻量版 – 腾讯混元开源的Hy4量化压缩模型

Claude Fable 5.1 – Anthropic 推出的最新旗舰大模型

开源版Retool来了,60+组件拖拽搭后台

Claude Opus 5来了:半价逼近Fable 5

腾讯开源260个真实任务,考AI打工能力

美团开源AI考场:813个Minecraft任务